多模态网络
在Transformer模型成功解决NLP任务后,相同或类似的架构也被应用于计算机视觉任务。越来越多的人开始关注构建能够结合视觉和自然语言能力的模型。其中一个尝试是由OpenAI完成的,称为CLIP和…
多模态网络
在Transformer模型成功解决NLP任务后,相同或类似的架构也被应用于计算机视觉任务。越来越多的人开始关注构建能够结合视觉和自然语言能力的模型。其中一个尝试是由OpenAI完成的,称为CLIP和DALL.E。
对比图像预训练(CLIP)
CLIP的核心思想是能够比较文本提示与图像,并确定图像与提示的匹配程度。
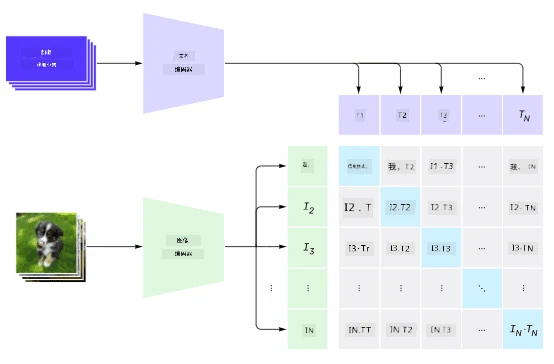
图片来源于这篇博客
该模型通过从互联网获取的图像及其标题进行训练。对于每个批次,我们获取N对(图像,文本),并将它们转换为一些向量表示I,..., I / T,..., T。这些表示随后进行匹配。损失函数的定义是最大化对应一对(例如I和T)的向量之间的余弦相似度,同时最小化所有其他对之间的余弦相似度。这就是为什么这种方法被称为对比学习。
CLIP模型/库可以从OpenAI GitHub获取。该方法在这篇博客中有所描述,并在这篇论文中有更详细的说明。
一旦该模型被预训练,我们可以给它一批图像和一批文本提示,它将返回一个概率张量。CLIP可以用于以下任务:
图像分类
假设我们需要将图像分类为猫、狗和人类。在这种情况下,我们可以给模型一个图像,以及一系列文本提示:“一张猫的图片”、“一张狗的图片”、“一张人类的图片”。在结果的3个概率向量中,我们只需选择值最高的索引。
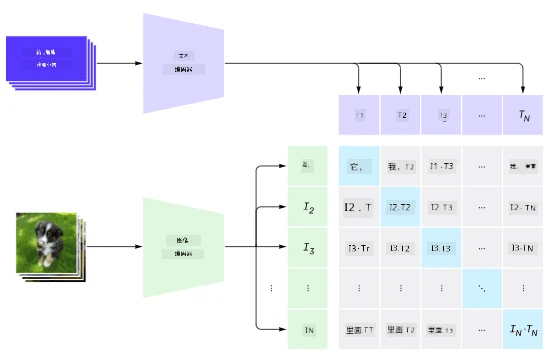
图片来源于这篇博客
基于文本的图像搜索
我们也可以反过来操作。如果我们有一组图像,我们可以将这组图像传递给模型,并提供一个文本提示——这将返回与给定提示最相似的图像。
✍️ 示例:使用CLIP进行图像分类和图像搜索
打开Clip.ipynb笔记本,查看CLIP的实际应用。
使用VQGAN+CLIP进行图像生成
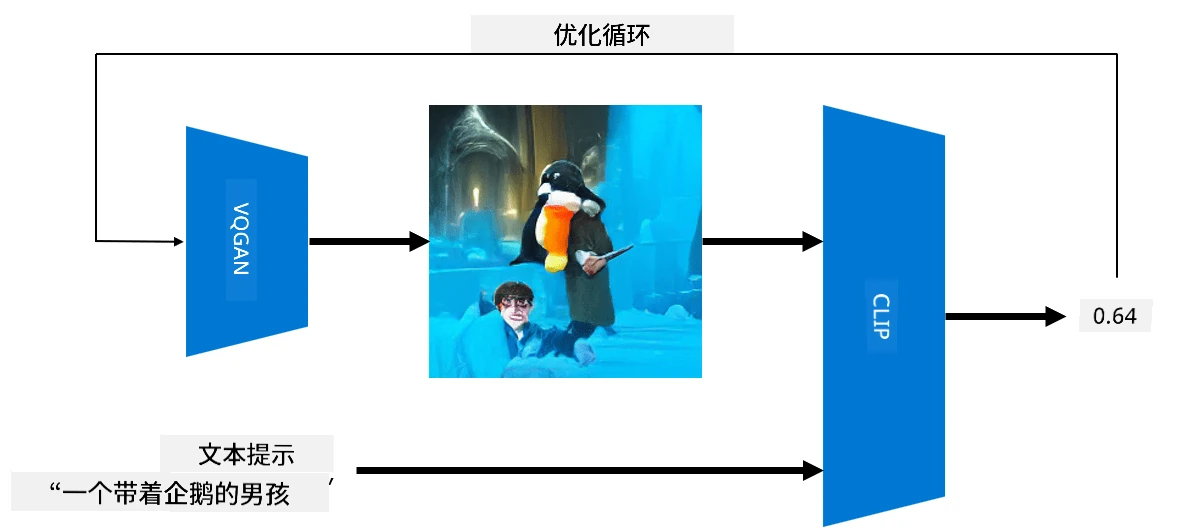
CLIP还可以用于从文本提示生成图像。为了实现这一点,我们需要一个生成器模型,能够根据某些向量输入生成图像。其中一个这样的模型称为VQGAN(向量量化GAN)。
VQGAN与普通GAN的主要区别在于以下几点:
- 使用自回归Transformer架构生成一系列上下文丰富的视觉部分,这些部分组成图像。这些视觉部分由卷积神经网络(CNN)学习。