深度强化学习
强化学习(RL)被认为是机器学习的基本范式之一,与监督学习和无监督学习并列。在监督学习中,我们依赖于具有已知结果的数据集,而强化学习则基于通过实践学习。例如,当我们第一次看到一个电脑游戏时,即使不知道…
深度强化学习
强化学习(RL)被认为是机器学习的基本范式之一,与监督学习和无监督学习并列。在监督学习中,我们依赖于具有已知结果的数据集,而强化学习则基于通过实践学习。例如,当我们第一次看到一个电脑游戏时,即使不知道规则,我们也会开始玩,并通过玩游戏和调整行为逐渐提高自己的技能。
课前测验
要进行强化学习,我们需要:
- 一个环境或模拟器,它定义了游戏规则。我们应该能够在模拟器中运行实验并观察结果。
- 某种奖励函数,它指示我们的实验是否成功。例如,在学习玩电脑游戏时,奖励可以是我们的最终得分。
基于奖励函数,我们应该能够调整自己的行为并提高技能,以便下一次表现更好。强化学习与其他类型的机器学习的主要区别在于,在强化学习中,我们通常不知道自己是否赢了或输了,直到游戏结束。因此,我们无法判断单独的某个动作是否是好的——我们只有在游戏结束时才会收到奖励。
在强化学习过程中,我们通常会进行许多实验。在每次实验中,我们需要在遵循迄今为止学到的最佳策略(利用)和探索新的可能状态(探索)之间找到平衡。
OpenAI Gym
一个非常适合强化学习的工具是 OpenAI Gym——一个模拟环境,它可以模拟许多不同的环境,从 Atari 游戏到物理学中的杆平衡问题。它是训练强化学习算法最流行的模拟环境之一,由 OpenAI 维护。
Note: 你可以在 这里 查看 OpenAI Gym 提供的所有环境。
CartPole 平衡
你可能都见过现代平衡设备,比如 Segway 或 Gyroscooters。它们能够通过调整轮子来响应加速度计或陀螺仪的信号,从而自动保持平衡。在本节中,我们将学习如何解决一个类似的问题——杆平衡。这类似于马戏团表演者需要在手上平衡杆的情况——但这种杆平衡仅发生在一维空间中。
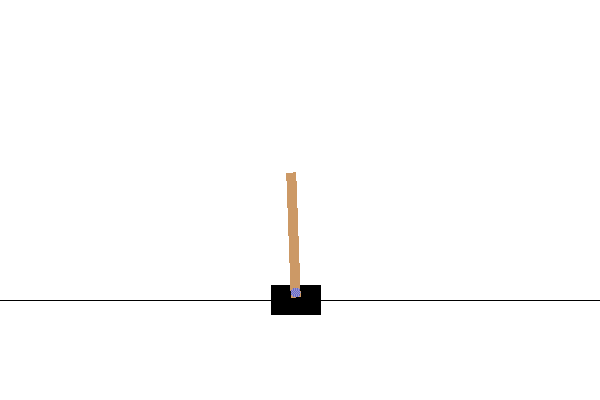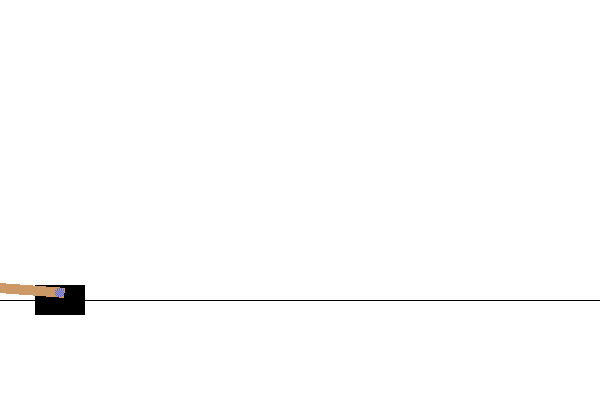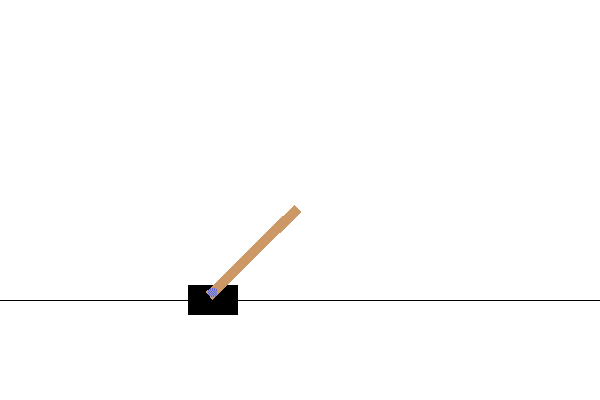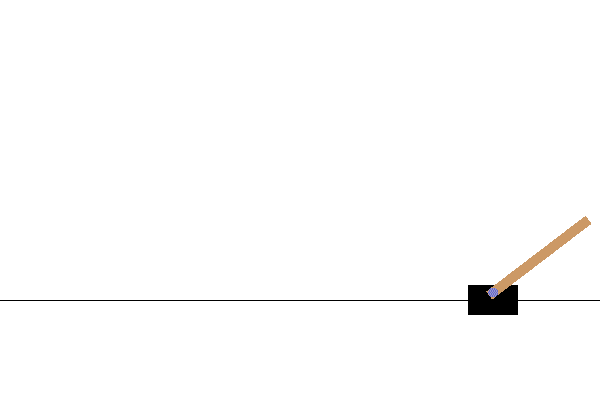
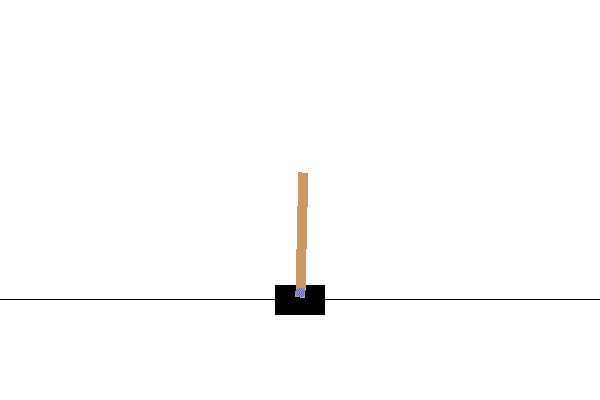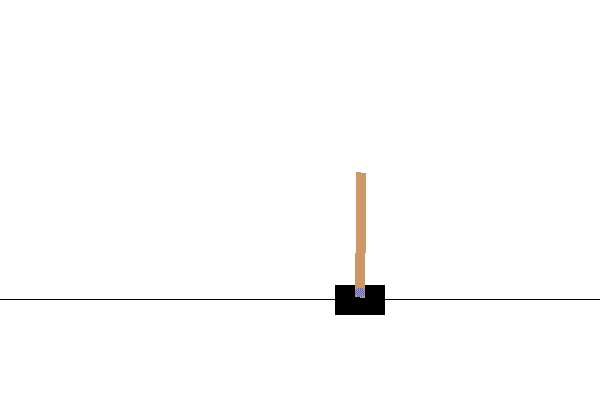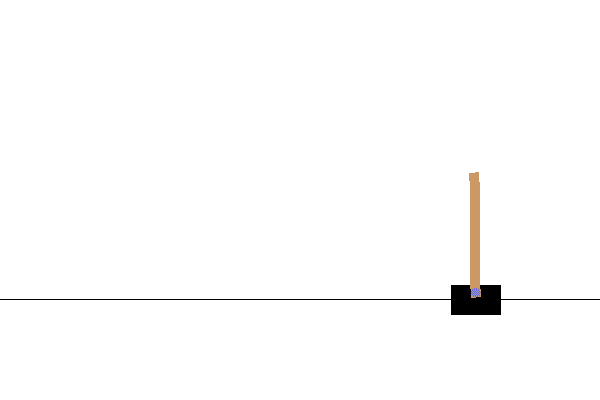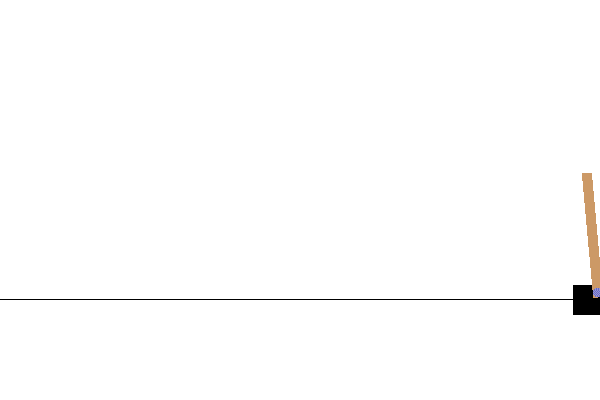
一种简化的平衡问题被称为 CartPole 问题。在 CartPole 世界中,我们有一个可以左右移动的水平滑块,目标是在滑块上方保持一个垂直杆的平衡。
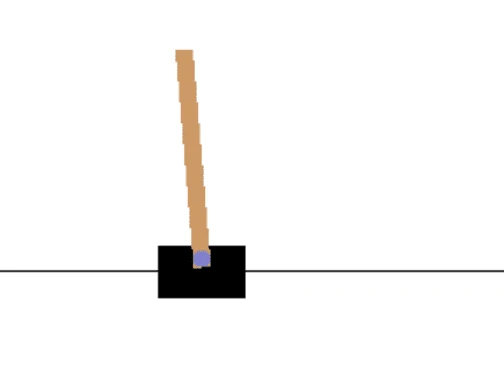
要创建和使用这个环境,我们需要几行 Python 代码:
import gym
env = gym.make("CartPole-v1")

env.reset()
done = False
total_reward = 0
while not done:
   env.render()
   action = env.action_space.sample()
   observaton, reward, done, info = env.step(action)
   total_reward += reward

print(f"Total reward: {total_reward}")
每个环境都可以通过以下方式访问:
env.reset开始一个新的实验env.step执行一个模拟步骤。它接收来自动作空间的一个动作,并返回一个观察值(来自观察空间),以及奖励和终止标志。
在上面的示例中,我们在每一步执行随机动作,因此实验的持续时间非常短: