注意机制与Transformer
在自然语言处理领域中,机器翻译是一个非常重要的问题,它是像谷歌翻译这样的工具的核心任务。在本节中,我们将重点讨论机器翻译,或者更广泛地说,任何序列到序列任务(也称为句子转换)。
注意机制与Transformer
课前测验
在自然语言处理领域中,机器翻译是一个非常重要的问题,它是像谷歌翻译这样的工具的核心任务。在本节中,我们将重点讨论机器翻译,或者更广泛地说,任何序列到序列任务(也称为句子转换)。
使用RNN时,序列到序列任务通过两个循环网络实现,其中一个网络,即编码器,将输入序列压缩为一个隐藏状态,而另一个网络,即解码器,将隐藏状态展开为翻译结果。这种方法存在一些问题:
- 编码器网络的最终状态难以记住句子的开头,从而导致模型在处理长句子时质量较差。
- 序列中的所有词对结果的影响相同。然而在实际中,输入序列中的某些词对输出序列的影响往往比其他词更大。
注意机制提供了一种方法,可以对每个输入向量对RNN输出预测的上下文影响进行加权。其实现方式是创建输入RNN的中间状态与输出RNN之间的快捷路径。这样,在生成输出符号yt时,我们会考虑所有输入隐藏状态hi,并赋予不同的权重系数αt,i。
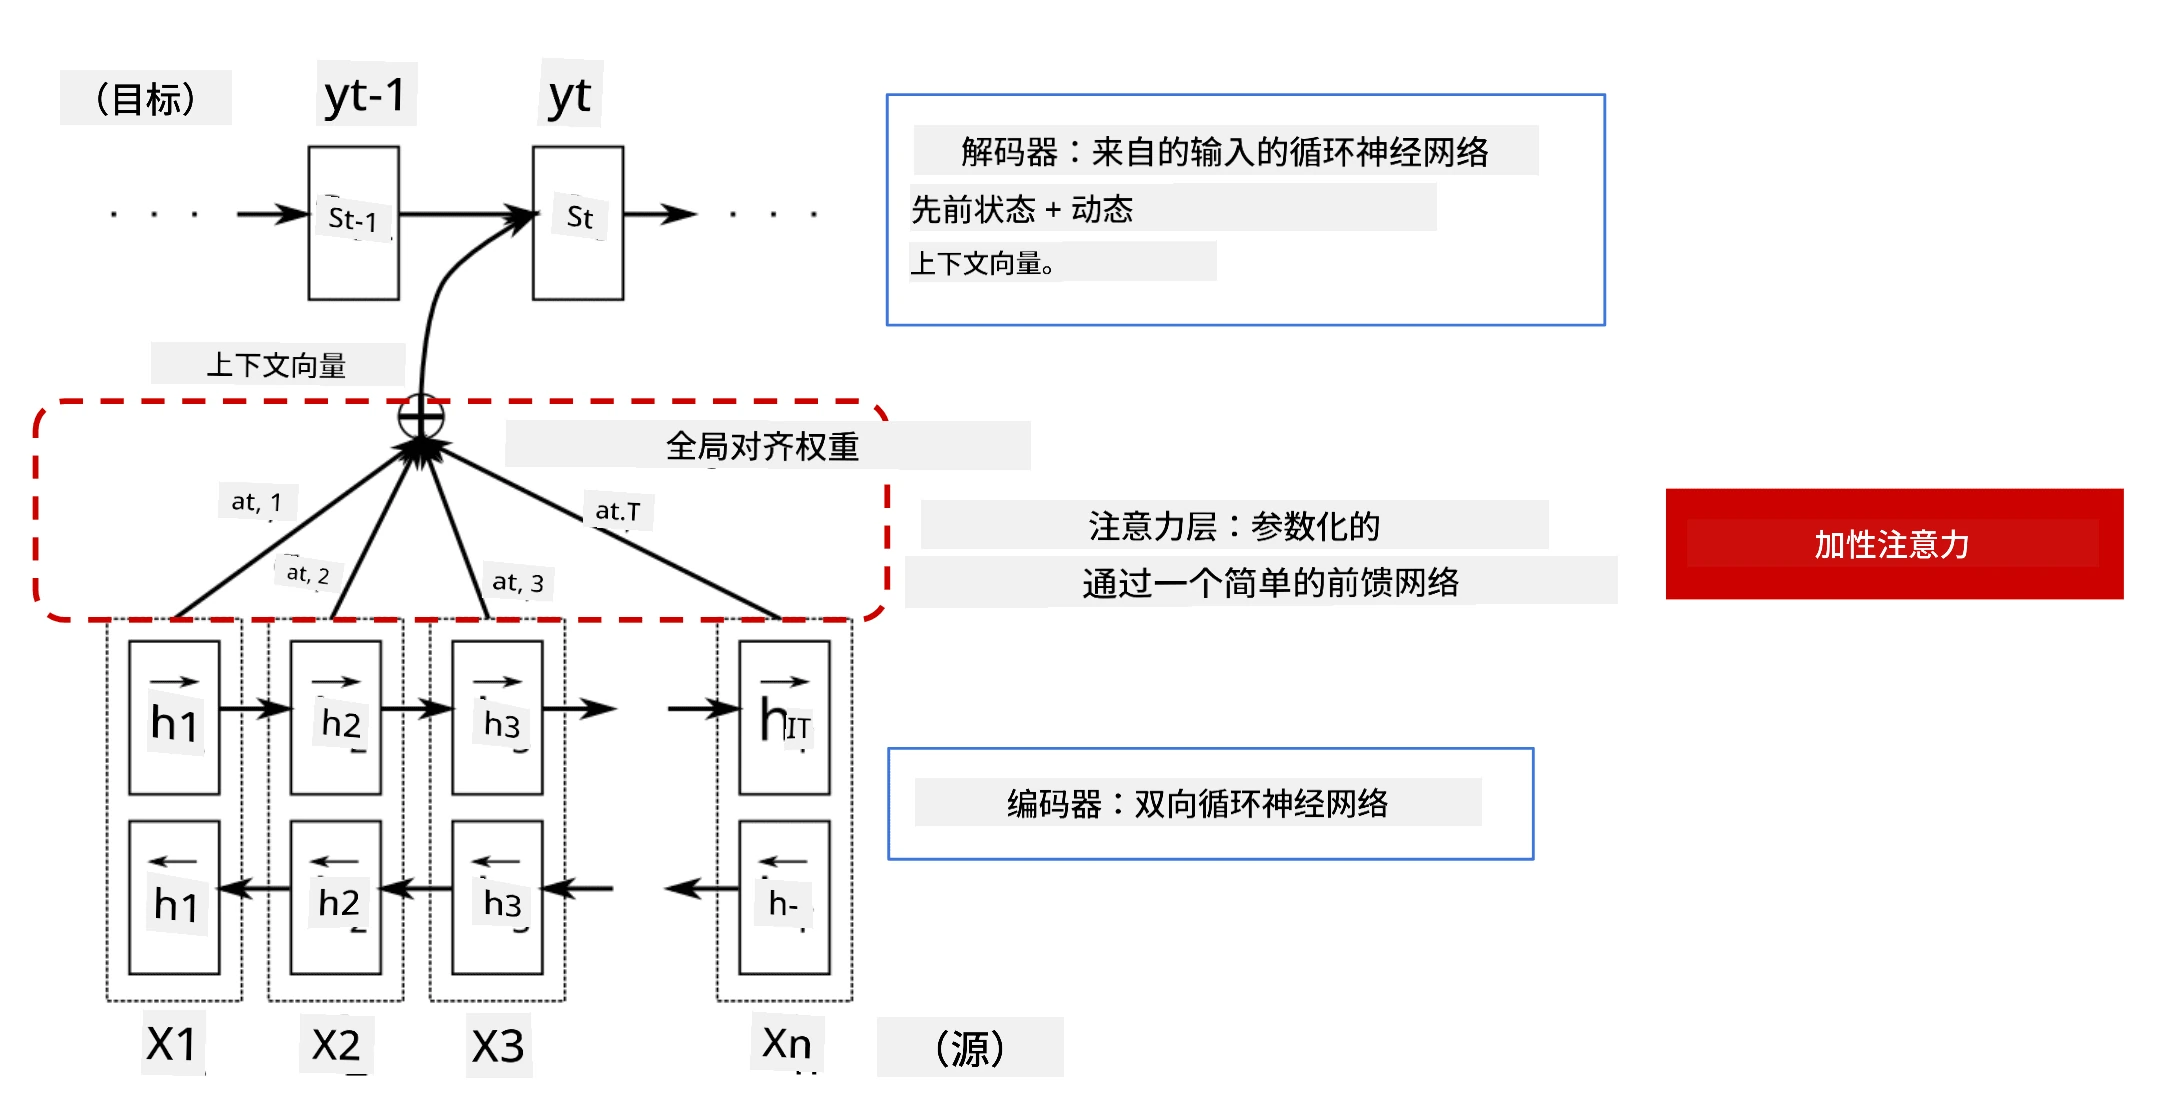
Bahdanau等人,2015中的加性注意机制编码器-解码器模型,图片来源于这篇博客
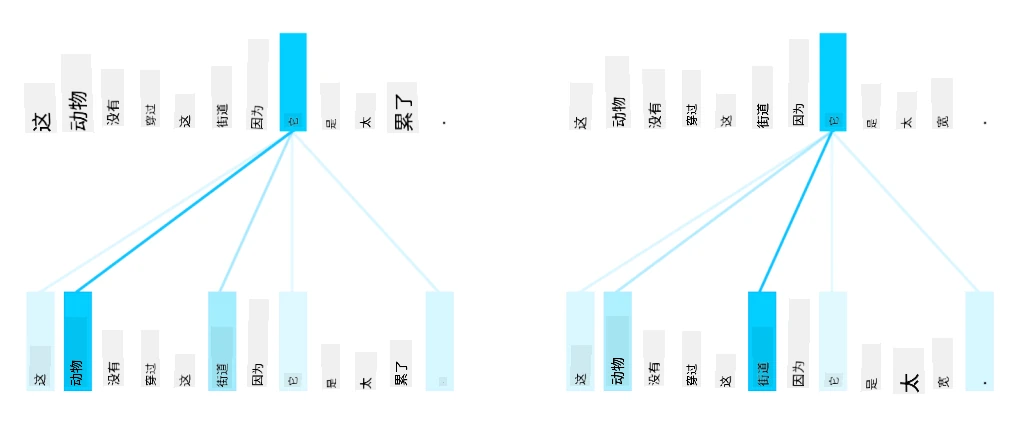
注意矩阵{αi,j}表示某些输入词在生成输出序列中某个词时的影响程度。下面是一个这样的矩阵示例:
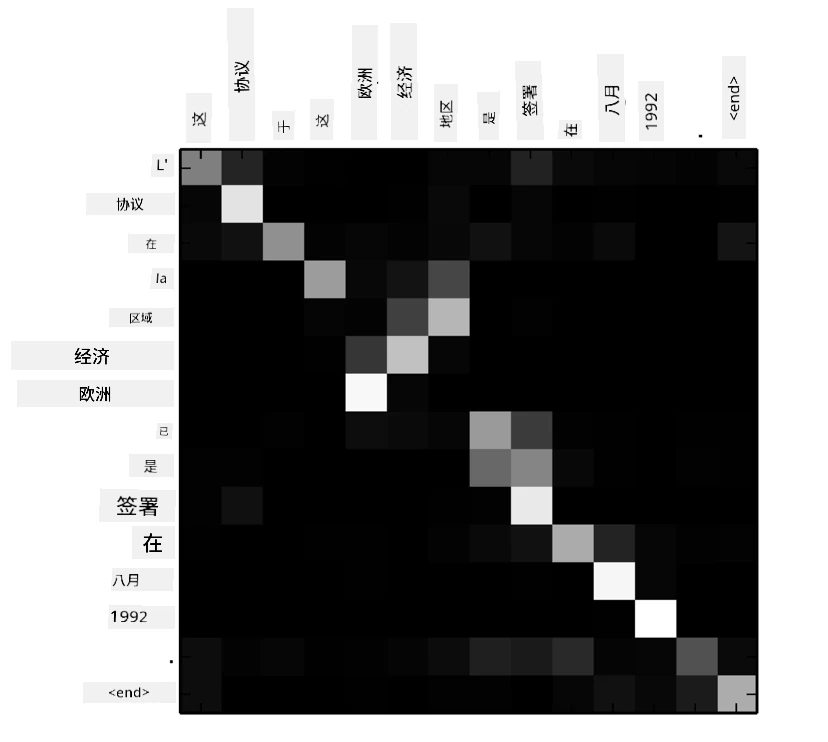
图片来自Bahdanau等人,2015(图3)
注意机制是当前或接近当前自然语言处理领域的最先进技术的关键所在。然而,添加注意机制会显著增加模型参数的数量,从而导致RNN的扩展问题。RNN扩展的一个关键限制是模型的循环性质使得训练难以批量化和并行化。在RNN中,序列的每个元素都需要按顺序处理,这意味着它无法轻松并行化。
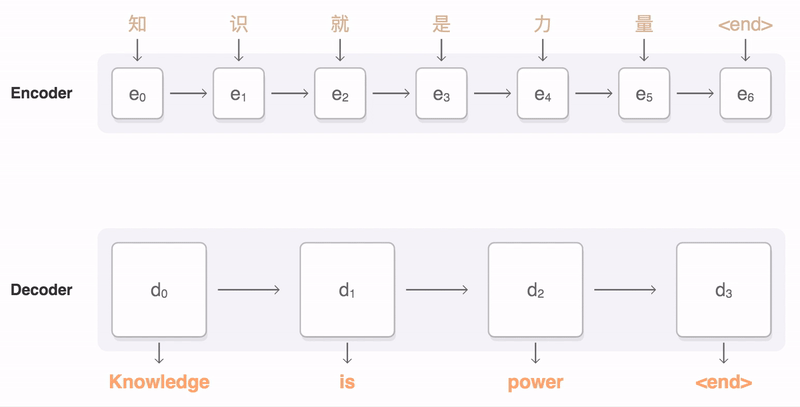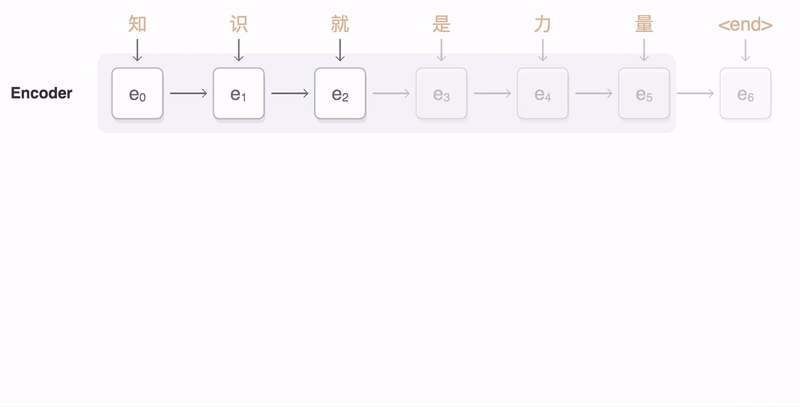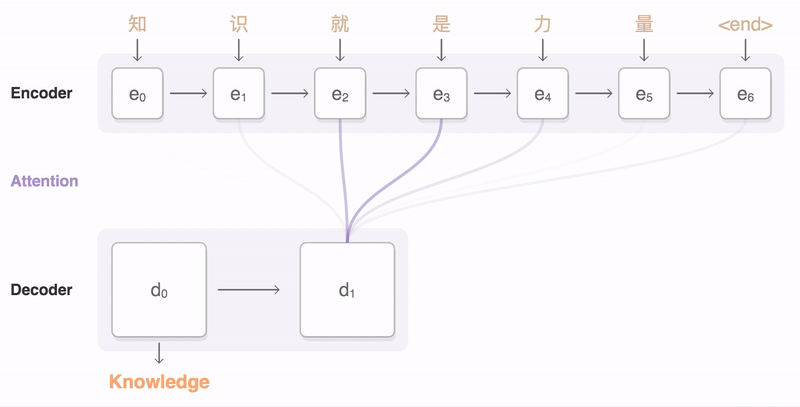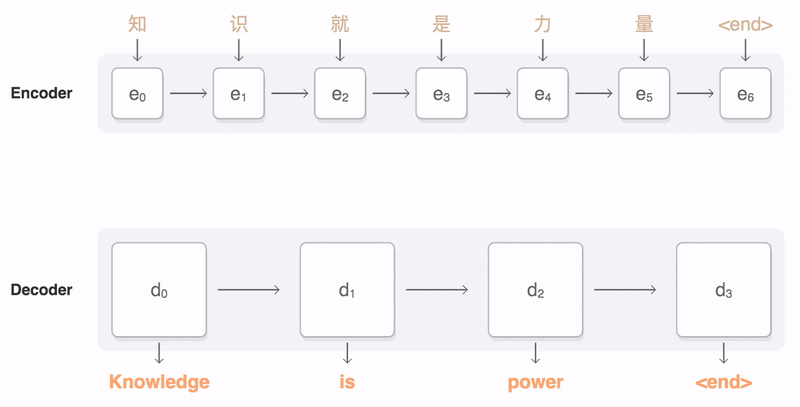
图片来源于谷歌博客
注意机制的采用结合了这一限制,促成了如今我们所熟知和使用的最先进的Transformer模型的诞生,例如BERT和Open-GPT3。
Transformer模型
Transformer的核心思想之一是避免RNN的顺序处理特性,并创建一个在训练过程中可并行化的模型。这通过以下两个想法实现:
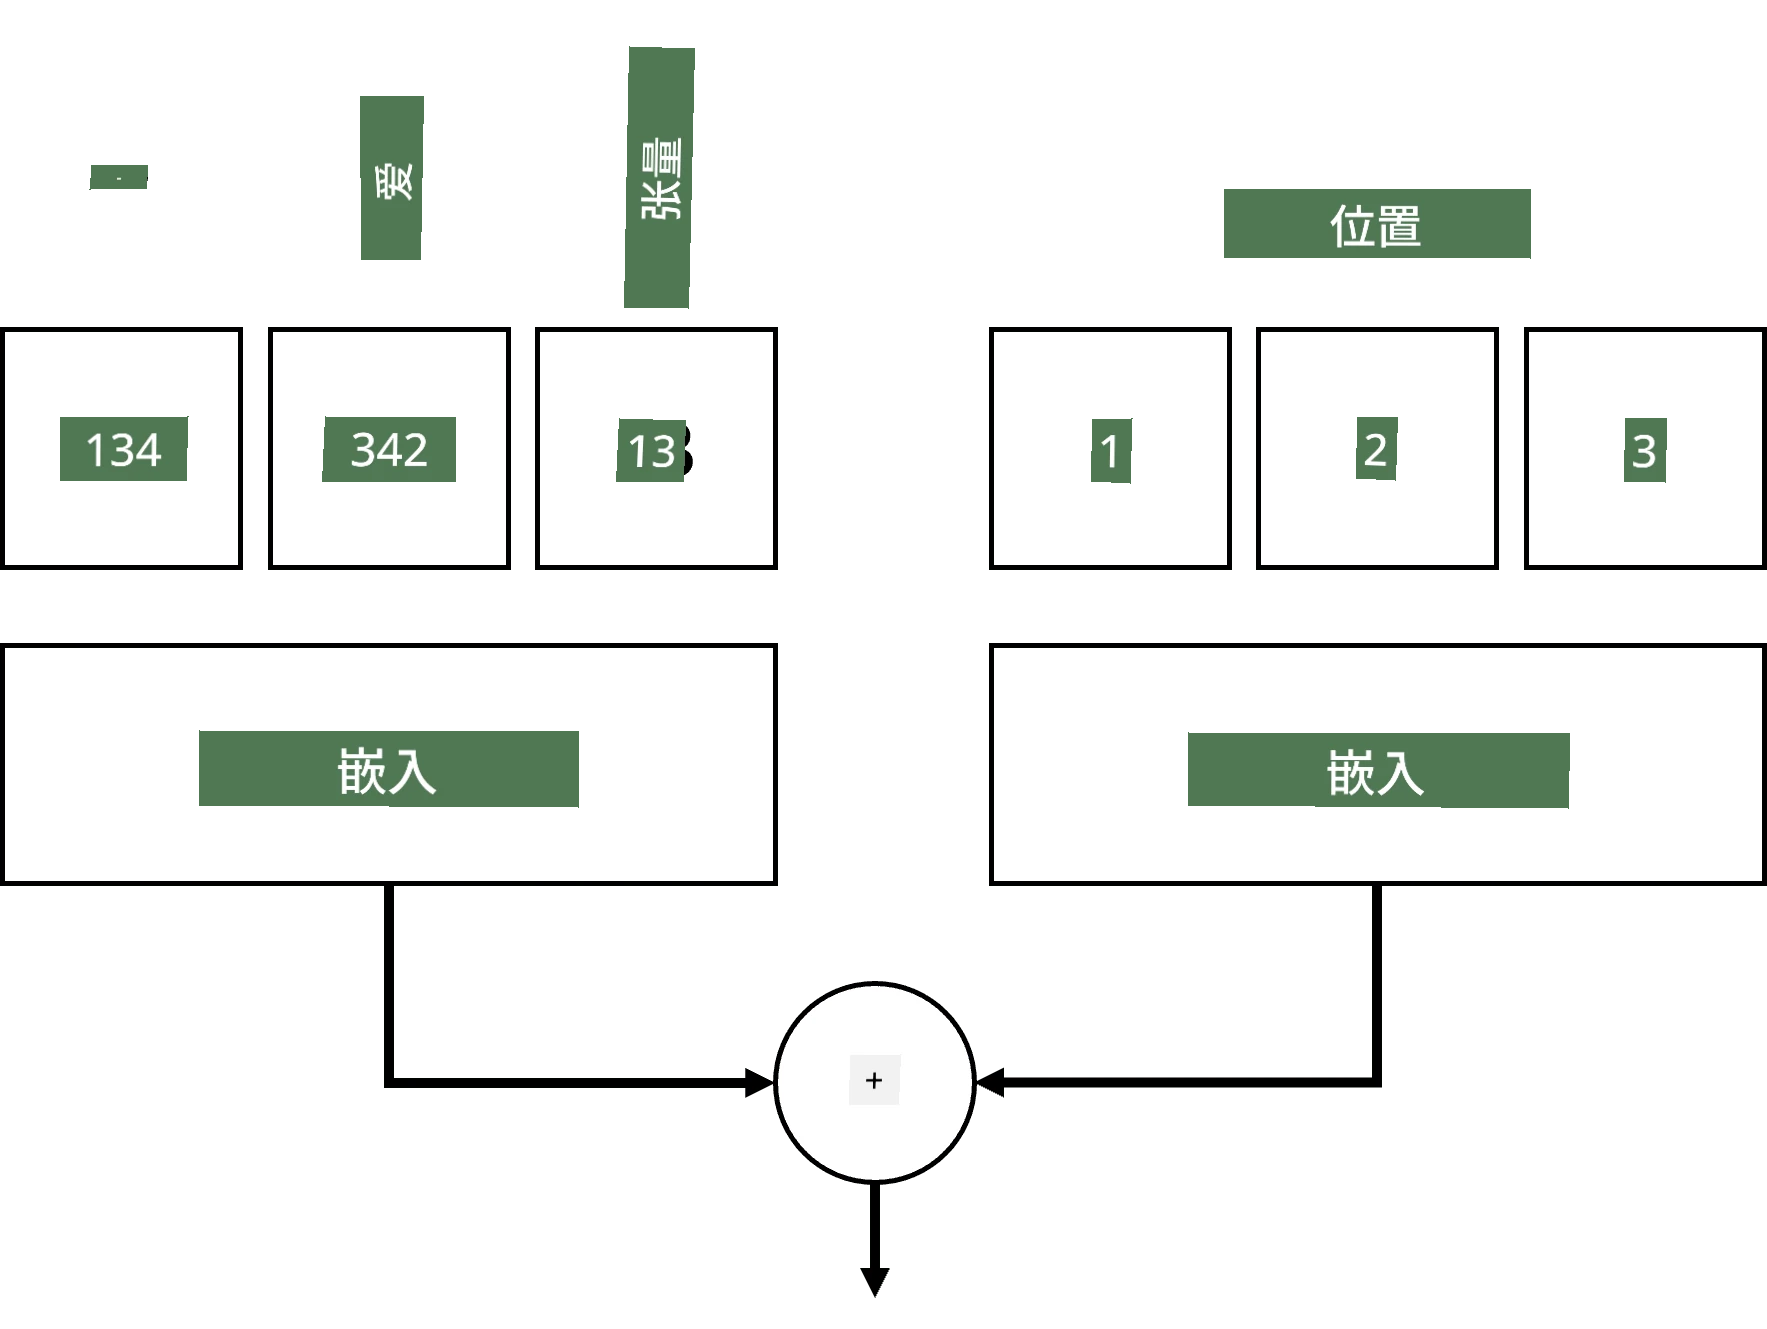
- 位置编码
- 使用自注意机制捕捉模式,而不是使用RNN(或CNN)(这也是为什么介绍Transformer的论文被称为*Attention is all you need*)
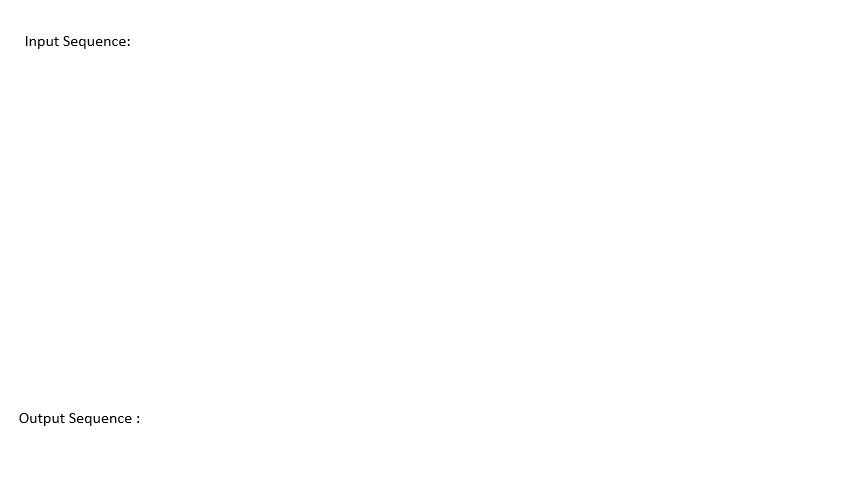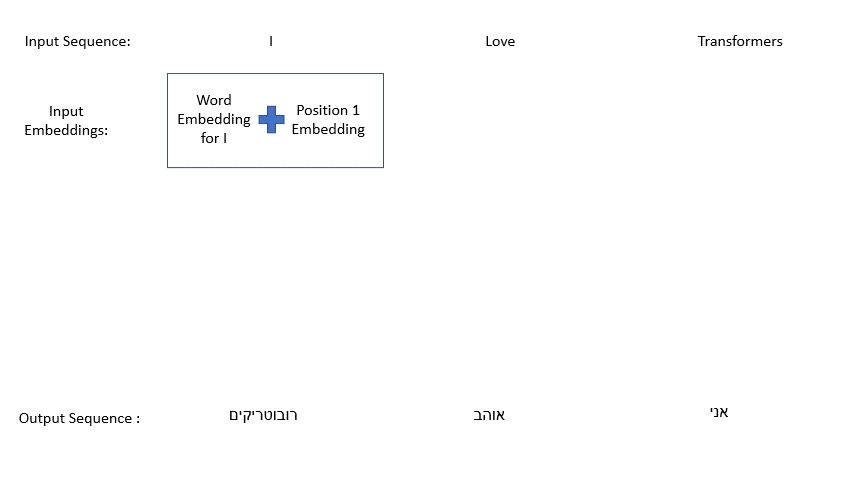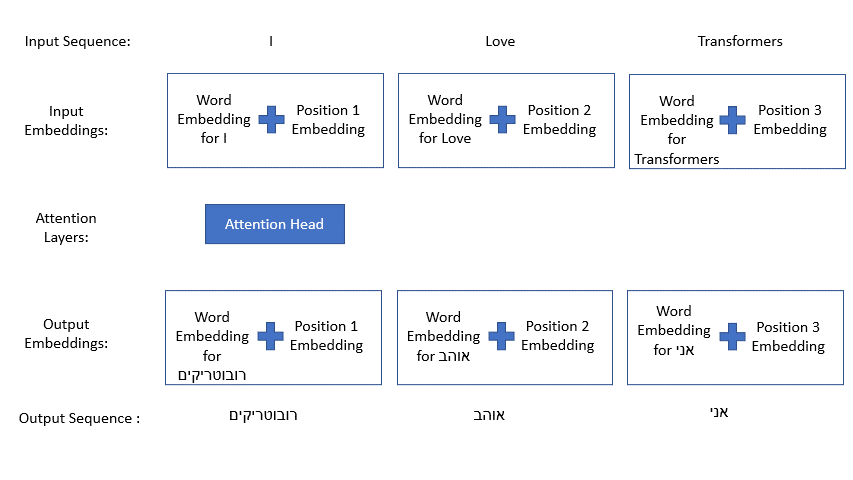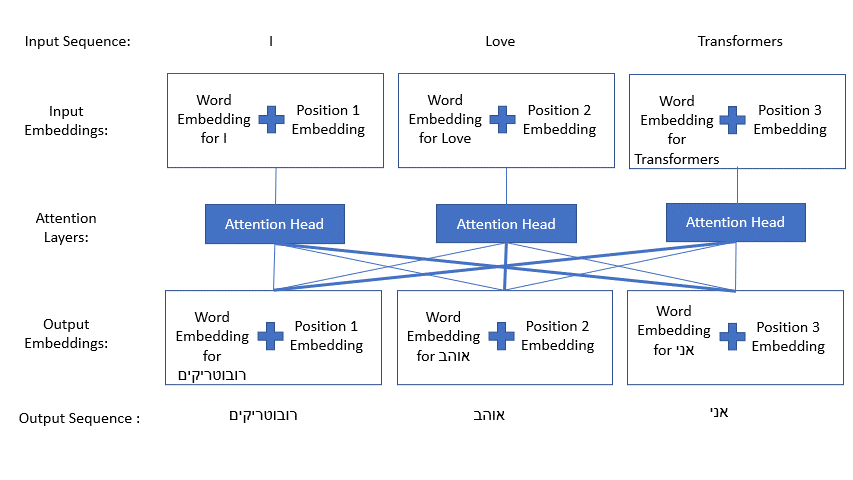
位置编码/嵌入
位置编码的思想如下: