自动编码器
在训练 CNN 时,一个问题是我们需要大量的标注数据。在图像分类的情况下,我们需要将图像分成不同的类别,这通常需要手动完成。
1 小时
自动编码器
在训练 CNN 时,一个问题是我们需要大量的标注数据。在图像分类的情况下,我们需要将图像分成不同的类别,这通常需要手动完成。
课前测验
然而,我们可能希望使用原始(未标注)数据来训练 CNN 特征提取器,这被称为自监督学习。在这种情况下,我们将训练图像同时作为网络的输入和输出。自动编码器的核心思想是,我们会有一个编码器网络,将输入图像转换为某种潜在空间(通常是一个较小尺寸的向量),然后通过解码器网络来重建原始图像。
✅ 自动编码器 是“一种用于学习未标注数据高效编码的人工神经网络。”
由于我们训练自动编码器的目标是尽可能捕捉原始图像的信息以实现准确的重建,网络会尝试找到输入图像的最佳嵌入以捕捉其意义。
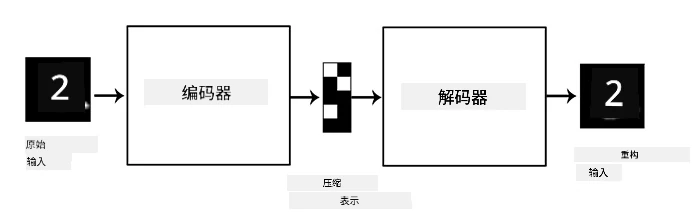
图片来源:Keras 博客
自动编码器的应用场景
虽然重建原始图像本身似乎没有太大的实际用途,但在以下场景中,自动编码器特别有用:
- 降低图像维度以便可视化或训练图像嵌入。通常,自动编码器比 PCA 效果更好,因为它考虑了图像的空间特性和层次化特征。
- 去噪,即去除图像中的噪声。由于噪声包含了大量无用信息,自动编码器无法将所有噪声信息压缩到相对较小的潜在空间中,因此它只捕捉图像的重要部分。在训练去噪器时,我们以原始图像为目标,并使用人工添加噪声的图像作为自动编码器的输入。
- 超分辨率,即提高图像分辨率。我们以高分辨率图像为目标,并使用低分辨率图像作为自动编码器的输入。
- 生成模型。一旦我们训练了自动编码器,解码器部分可以用来从随机潜在向量生成新对象。
变分自动编码器 (VAE)
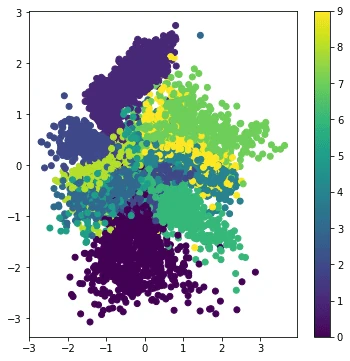
传统的自动编码器通过某种方式降低输入数据的维度,从而提取输入图像的重要特征。然而,潜在向量通常没有太多意义。换句话说,以 MNIST 数据集为例,确定哪些数字对应于不同的潜在向量并不容易,因为相近的潜在向量不一定对应于相同的数字。
另一方面,要训练生成模型,最好对潜在空间有一定的理解。这一想法引导我们进入变分自动编码器 (VAE)。
VAE 是一种自动编码器,它学习预测潜在参数的统计分布,即所谓的潜在分布。例如,我们可能希望潜在向量呈正态分布,具有某个均值 zmean 和标准差 zsigma(均值和标准差都是某个维度 d 的向量)。VAE 的编码器学习预测这些参数,然后解码器从该分布中随机抽取一个向量以重建对象。
总结如下:
- 从输入向量预测
z_mean和z_log_sigma(我们预测的是标准差的对数而不是标准差本身) - 从分布 N(zmean,exp(zlog_sigma)) 中抽取一个向量
sample - 解码器尝试使用
sample作为输入向量解码原始图像
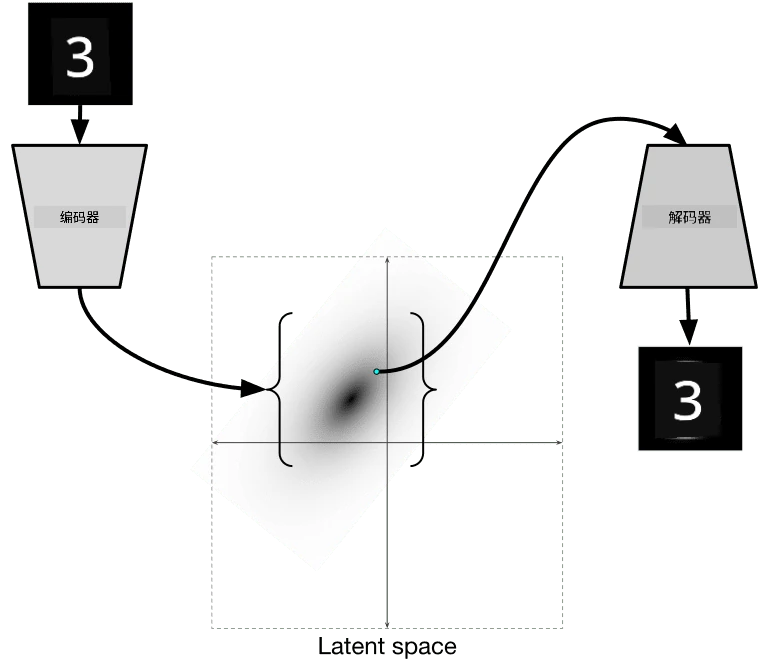
图片来源:Isaak Dykeman 的博客文章